데이터 정리하고 패턴 찾기
2주차에 불러온 데이터는 아직 믿을 수 있는 상태가 아닙니다. 빈 값과 이상한 값을 확인하고 나서야 시간대·요일·성별·연령대별 패턴이 눈에 보이고, 그 패턴을 한 번 더 의심해야 결론으로 쓸 수 있습니다.
 이 챕터 실습 노트북 — Colab에서 바로 열기
오늘 2시간, 이렇게 진행합니다
| 시간 | 할 일 | 끝나면 남는 것 |
|---|---|---|
| 0:00–0:10 | 도구 확인 — 2주차 작업 폴더에서 claude(또는 codex)를 켜고 "3-suspect 스킬 보여?"에 답이 오는지 | 실습 준비 완료 |
| 0:10–0:25 | 결측치·중복·이상치, groupby가 뭔지 (아래 설명) | 오늘 할 일 이해 |
| 0:25–0:50 | 미션 1 · 결측치·중복·이상치 확인 | 정리 결과 요약, 이상치 메모 |
| 0:50–1:00 | 쉬는 시간 · 2주차 데이터가 없는 분은 백업 데이터나 위 Colab 노트북으로 전환 | |
| 1:00–1:25 | 미션 2 · 3-suspect 스킬로 패턴 그래프 3개 | eda_report.html |
| 1:25–1:50 | 미션 3 · 함정 판정표 작성, 2~3명 화면 공유 | traps_check.md |
| 1:50–2:00 | 완료 체크 · "예상과 달랐던 것" 한 줄 메모 · 4주차 예고 | 4주차 출발점 메모 |
정리해야 할 세 가지
결측치 확인. df.isna().sum()으로 빈 값이 많은 열을 먼저 찾습니다.
중복 확인. df.duplicated().sum()으로 같은 행이 겹쳐 들어왔는지 세고, 있으면 df.drop_duplicates()로 지웁니다. 생활인구는 (날짜, 시간대, 자치구)가 같은 행이 둘이면 중복입니다.
이상치 판단. 극단적인 값이 오류인지 실제 현상(예: 축제 당일 방문객 급증)인지 구분합니다.
💡 사실 2주차에 절반은 끝났습니다. 2-collect 스킬은 정리하면서 결측률·중복 건수·이상치 표시를
preprocessing_report.html에 남겨 둡니다. 오늘은 그 보고서를 열어 "무엇이 비었고, 무엇을 지웠고, 무엇이 튀는지"를 내 눈으로 확인하는 데서 시작합니다. 이 코드를 직접 실행해 보고 싶다면 위 Colab 노트북 1~3번 칸에 그대로 있습니다.
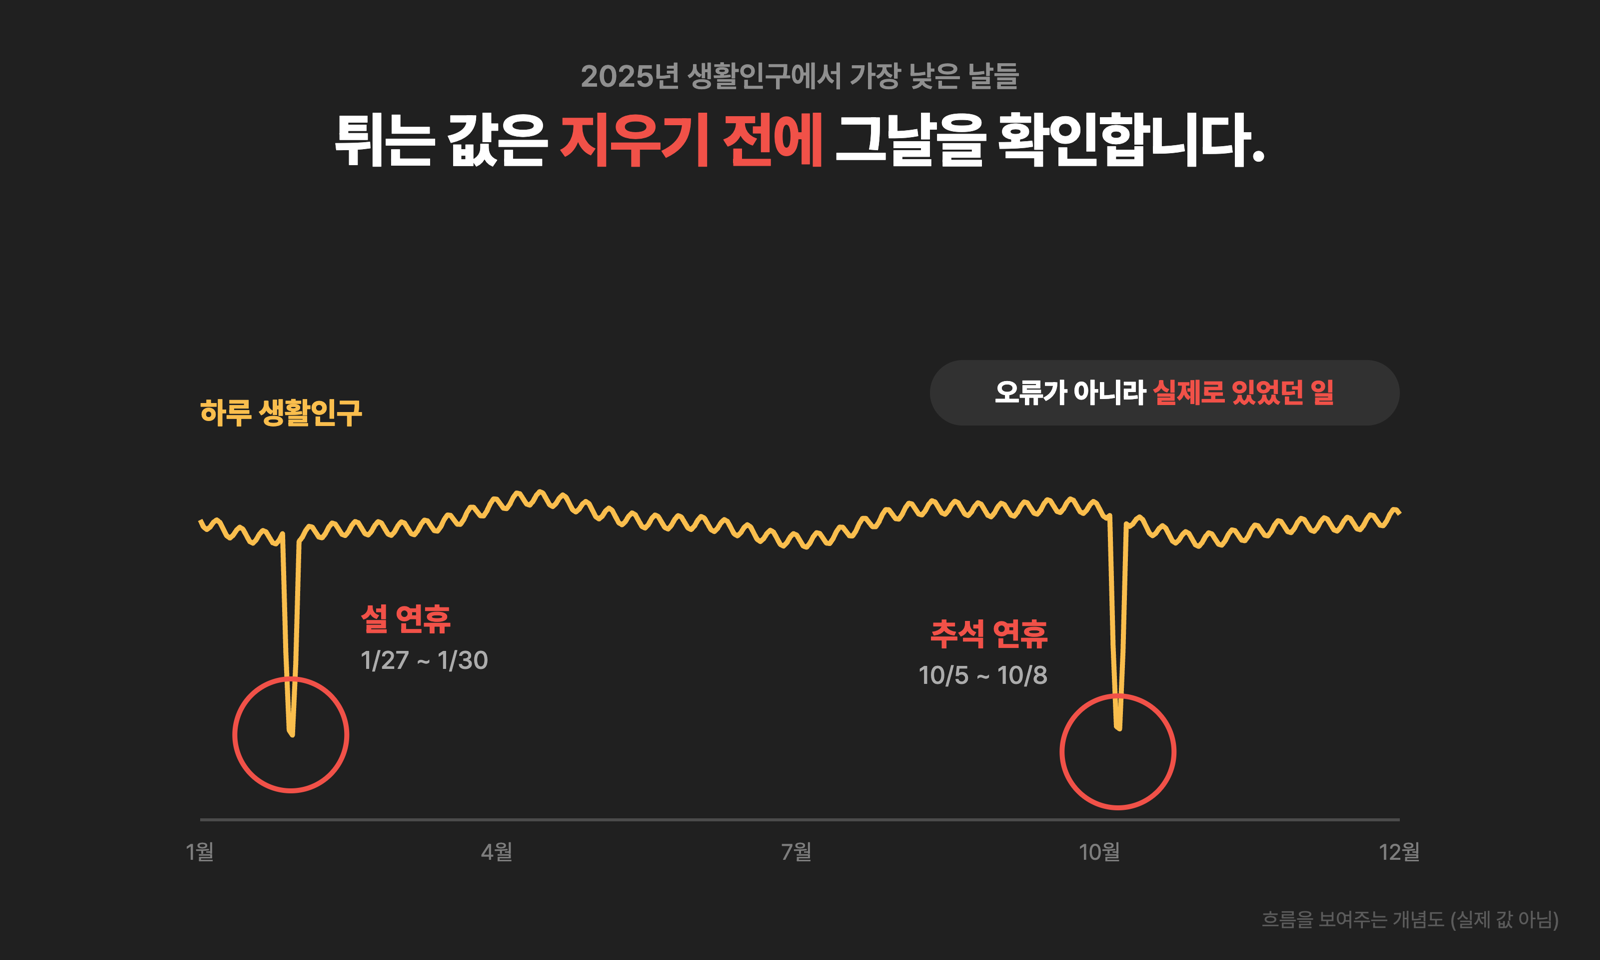
💡 막히면: 이상치를 무조건 지우지 마세요. 실제로 있었던 일(연휴·행사)일 수 있습니다. 2025년 생활인구에서 가장 낮은 날들은 오류가 아니라 설 연휴(1/27~1/30)와 추석 연휴(10/5~10/8)입니다. 추석 당일(10/6) 중구 생활인구는 평소의 절반 수준까지 떨어집니다. 지우기 전에 그 날짜에 무슨 일이 있었는지 먼저 확인합니다.
정리 후에야 보이는 것
정리된 데이터로 groupby(같은 값끼리 묶어 평균·합계를 내는 것)를 쓰면 시간대·요일·성별·연령대별로 묶어 비교할 수 있습니다. 오늘 목표는 이런 비교 그래프를 3개 만드는 것입니다.
결측치·중복이 섞인 원본
- 평균·합계가 실제보다 커지거나 작아짐
- 그래프가 들쭉날쭉해 패턴이 안 보임
groupby로 집계한 데이터
- 시간대별·요일별 흐름이 그래프로 드러남
- 다음 주 데이터 결합의 기준이 됨
★ 내외국인은 생활인구로 못 나눕니다. 2주차에 받은 자치구 단위 생활인구(
LOCAL_PEOPLE_GU)는 내국인만 담은 데이터라 성별·연령대는 있어도 외국인은 없습니다. 내외국인을 비교하고 싶다면 한국관광 데이터랩 방문자 데이터의 외국인 방문자 수를 쓰세요. 이때도 생활인구와 숫자를 직접 비교하지 말고 각각의 흐름(증감)만 봅니다.
Claude Code(또는 Codex)로 의심하기
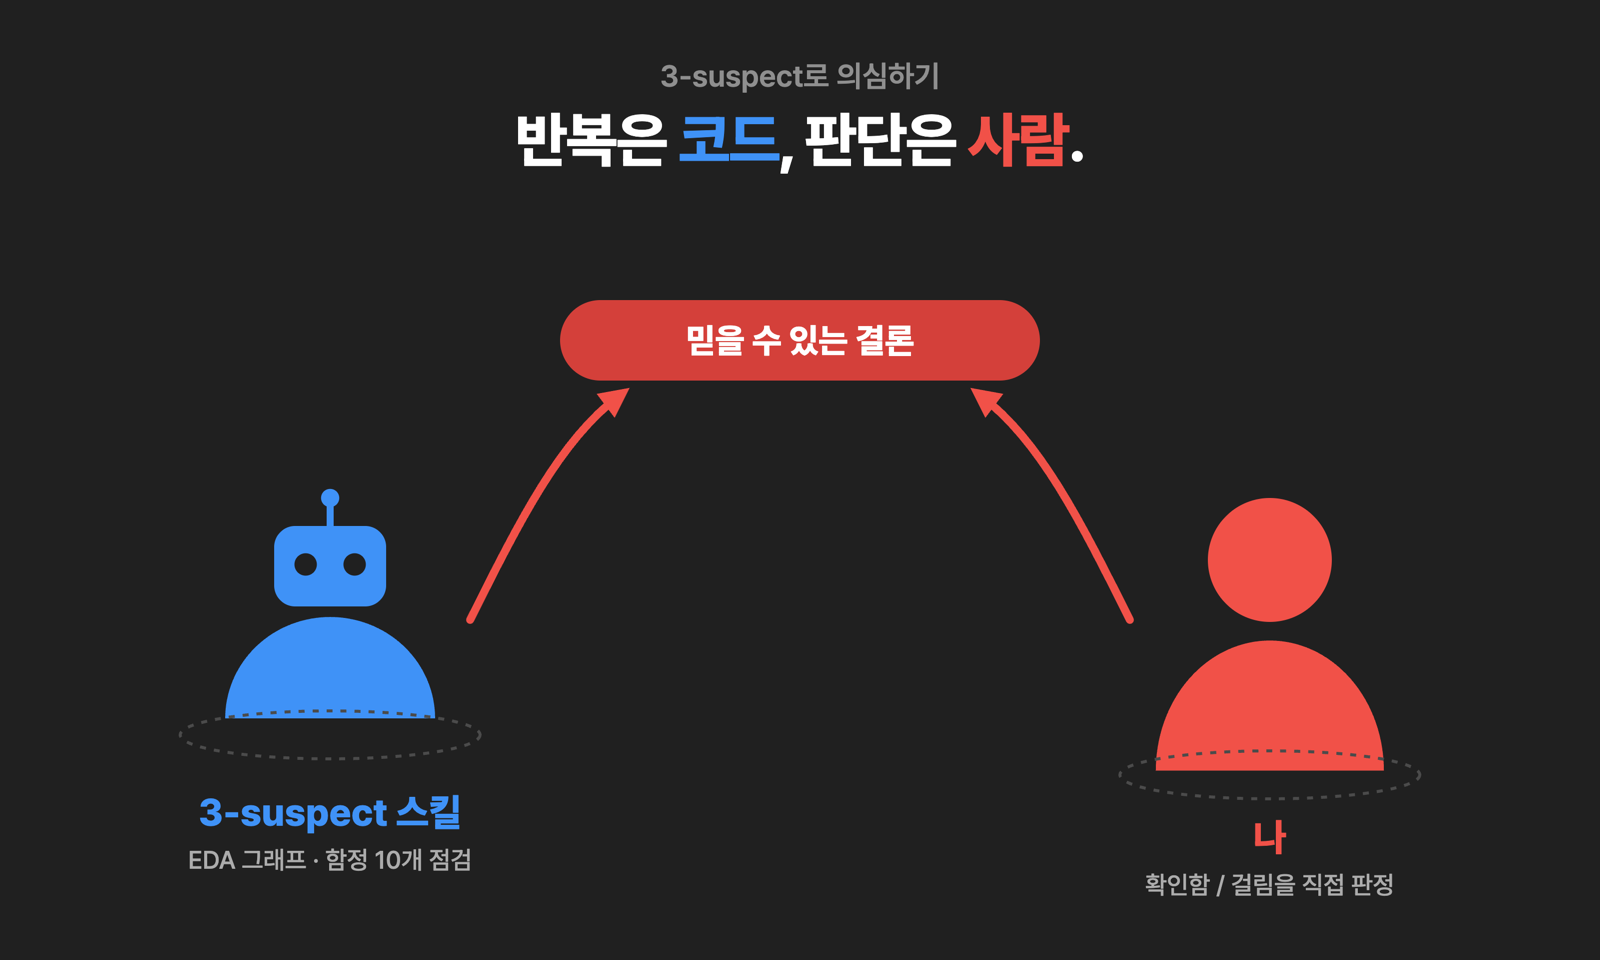
여기서부터는 3-suspect 스킬을 부릅니다. 스킬이 데이터 모양을 그려 보는 EDA 보고서(eda_report.html)를 만들고, "이 숫자가 진짜냐"를 묻는 함정 10개(기준 기간·평균의 함정·지표 대리 오류 등)를 하나씩 짚어 traps_check.md에 적습니다. 하지만 맞다/틀리다는 내가 판단합니다. 반복은 코드, 판단은 사람 — 이 구분이 이 챕터의 핵심입니다.
"3-suspect 스킬이 안 보여요"라면
Claude Code: 예전에 설치한 플러그인은 3-suspect가 없는 옛 버전일 수 있습니다. 아래 두 줄로 최신으로 바꾼 뒤 Claude Code를 껐다 켭니다.
/plugin marketplace update datapopcorn
/plugin install datapopcorn-analysis@datapopcornCodex: 2주차에 복사한 ~/.agents/skills/에 3-suspect 폴더가 있는지 확인합니다. 없으면 툴킷 레포 폴더에서 git pull 후 cp -R skills/* ~/.agents/skills/를 다시 실행합니다.
3-suspect는 1주차의 hypothesis.md(판정 기준)와 2주차의 preprocessing_report.html을 먼저 찾습니다. 없으면 거기서 멈추니, 아래 프롬프트처럼 "없으면 먼저 만들어줘"를 같이 넣습니다.
"datapopcorn-analysis의 3-suspect 스킬로 data/clean/ 데이터를 의심해줘. 먼저 preprocessing_report.html에서 결측·중복·이상치가 어떻게 처리됐는지 요약해줘. 그 보고서가 없으면 결측률·중복 건수·이상치 표시부터 만들어줘. hypothesis.md가 없으면 내 질문 '(1주차 질문)'과 가설 '(1주차 가설)'로 짧게 먼저 만들어줘. eda_report.html에는 (시간대/요일/성별/연령대) 중 3가지 기준으로 groupby 그래프를 넣고, 그래프 한글이 깨지지 않게 해줘. 마지막으로 함정 10개를 traps_check.md에 해당없음/확인함/걸림으로 판정하고, 걸림 항목은 내가 직접 확인할 방법도 같이 적어줘."
완성 예시 — 종로구 예시 리포트를 3-suspect로 다시 의심해 보면
종로구 예시의 초판("밤 9시 이후 1인당 매출 −57%", 지금 1·5주차 예시는 이 결과를 반영해 고친 버전)에 자료실 백업 데이터로 3-suspect 흐름을 그대로 적용한 결과물입니다. 내 결과물이 이런 모양으로 나오는지 비교해 보세요.
📊 eda_report.html
데이터 상태 확인(결측·중복·빠진 날짜) → 시간대·요일·성별·연령대 그래프 3개 → 숫자 다시 계산 → 함정 판정까지 한 페이지.
🧪 traps_check.md
함정 10개를 확인함 2개, 걸림 8개로 판정. 걸린 항목마다 근거와 조치를 적었습니다.
🎯 hypothesis.md
판정 기준 3개. 3-suspect는 여기 적힌 기준으로만 판정합니다. 재현 코드는 3_eda.py.
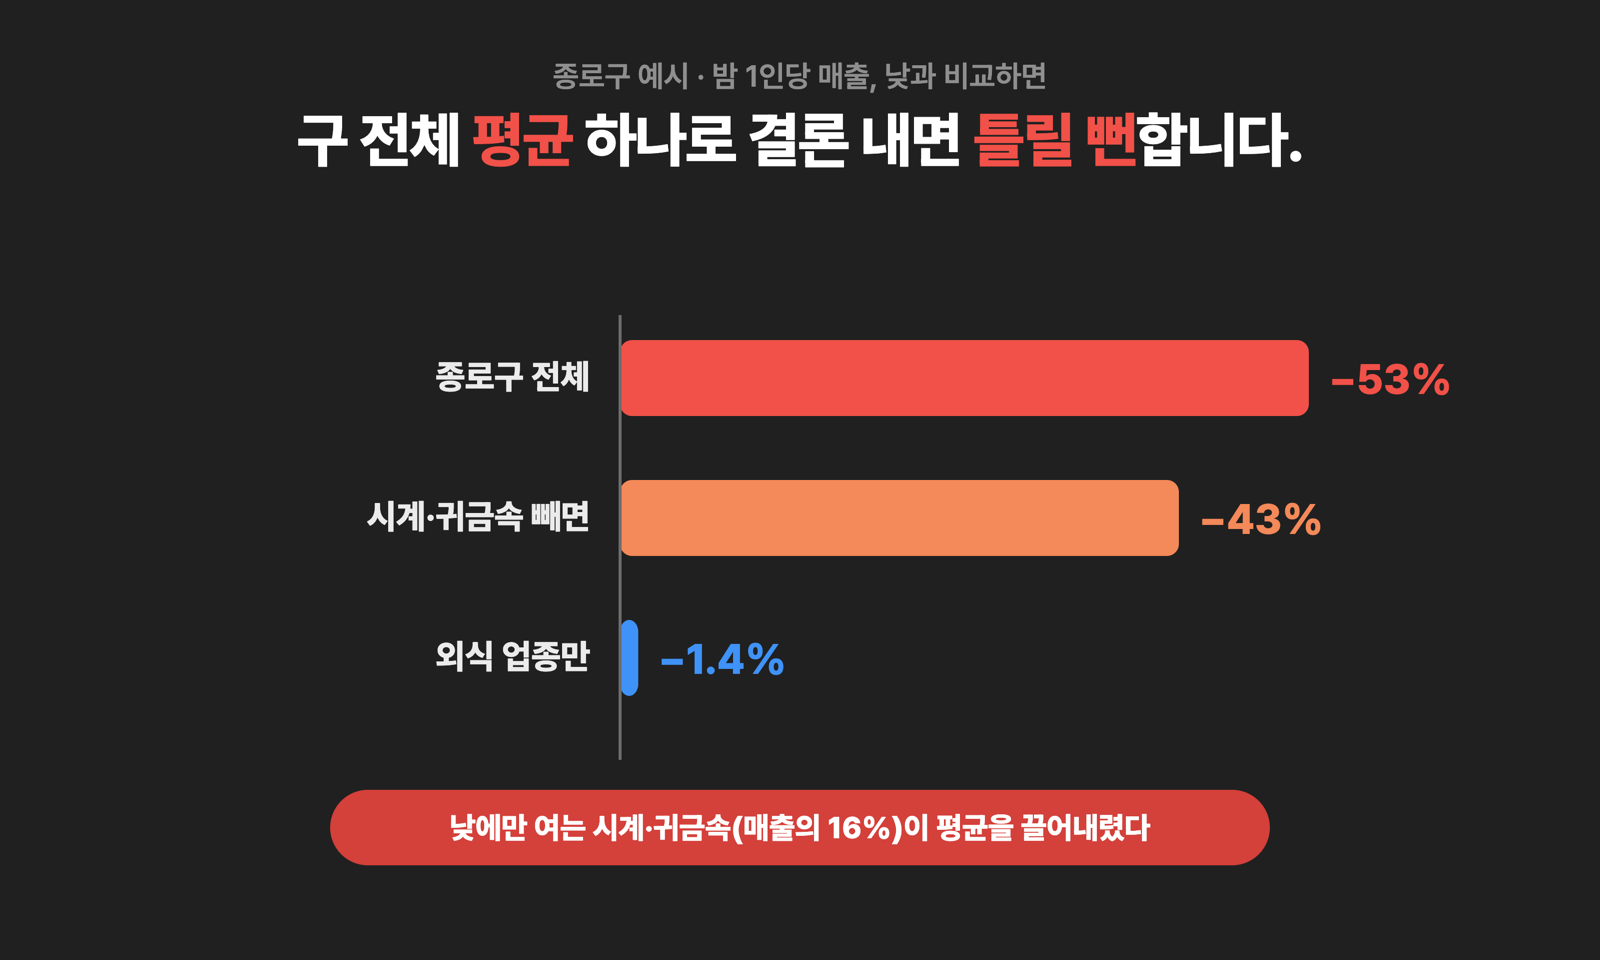
★ 의심했더니 결론이 바뀌었습니다. ① 시간대 구간 길이(3~6시간)를 맞추면 −57.3%가 아니라 −53%입니다. ② 외식 10개 업종만 보면 밤 1인당 매출은 −1.4%로 거의 안 떨어집니다. 낙폭의 상당 부분은 낮에만 장사하는 시계·귀금속(종로구 매출의 16%) 같은 업종이 밤에 문을 닫아서 생긴 것입니다. ③ 강남(−54%)·중구(−48%)도 비슷해 종로구만의 문제가 아닙니다. 숫자 자체는 맞았지만 해석은 틀릴 뻔했습니다. 이게 ③ 의심 단계를 하는 이유입니다.
관광·상권 데이터에서 실제로 걸리는 함정
스킬이 "해당없음"이라고 넘긴 항목도 아래 사례에 해당하면 다시 봅니다.
| 함정 | 이 과정 데이터에서는 | 이렇게 확인 |
|---|---|---|
| 단위 정의 | 데이터랩 방문자수는 같은 사람이 3일 오면 3명으로 세는 연인원입니다. | "방문객 ○명"이 아니라 "방문 ○건", 총량보다 증감으로 씁니다. |
| 지표 대리 오류 | 데이터랩 관광소비는 실제 전체 소비가 아니라 카드 결제 기반 추정치입니다. 상권 추정매출도 추정값입니다. | "매출 ○원"이라고 단정하지 말고 "추정"을 붙이고, 추세 비교에만 씁니다. |
| 기준 기간 | 생활인구는 하루 단위, 추정매출은 분기 단위, 데이터랩은 월 단위입니다. 설·추석이 낀 달도 있습니다. | 기간이 다른 합계를 그대로 나란히 놓지 않습니다. 같은 기간·같은 단위로 맞춘 뒤 비교합니다. |
| 단위 정의 + 평균의 함정 | 이 사이트 종로구 예시 리포트 초안에서 실제로 나온 실수: 종로구 전체는 1인당 매출 낙폭(−57%)으로, 관광특구는 매출 총액 낙폭(−69.8%)으로 계산해 놓고 "관광특구가 더 가파르다"고 비교했습니다. 같은 총액 기준이면 종로구 전체가 −72.5%로 오히려 더 컸습니다. | 두 숫자를 비교하기 전에 "둘 다 같은 지표(총액/1인당)인가?"를 먼저 묻습니다. |
| 평균의 함정 (업종 섞임) | 위 완성 예시에서 실제로 걸린 함정: 종로구 전체 평균은 밤에 −53%지만, 낮에만 여는 시계·귀금속 업종을 빼면 −43%, 외식만 보면 −1.4%입니다. | 구 전체 숫자 하나로 결론 내지 말고, 업종을 나눠 같은 계산을 한 번 더 합니다. |
정리되지 않은 데이터는 패턴도, 스킬이 짜준 코드의 결과도 믿을 수 없습니다. 함정 판정표에서 "걸림"이라고 나온 항목은 무시하지 말고 직접 확인합니다. 고칠 수 없으면 지우지 말고 5주차 리포트의 "한계"로 넘깁니다.
🧪 3주차 실습 · 단계별 미션
시나리오 — 2주차에 정리한 내 데이터를 확인하고, 핵심 그래프 3개를 그린 뒤, 그 숫자를 믿어도 되는지 함정 판정표로 따져 봅니다. 이 결과가 다음 주 인사이트 도출의 재료가 됩니다. 설치가 막힌 분은 위 Colab 노트북으로 같은 흐름을 진행합니다.
preprocessing_report.html을 열어 결측률·중복 건수·이상치 표시를 확인합니다. 보고서가 없으면 위 프롬프트의 앞부분만 보내 스킬에게 만들어 달라고 합니다. 튀는 날짜가 있으면 지우기 전에 그날 무슨 일(연휴·행사)이 있었는지 찾아 한 줄로 적습니다.
위 프롬프트로 3-suspect 스킬을 실행해, 시간대·요일·성별·연령대 중 3가지 기준의 방문 패턴 그래프를 eda_report.html로 받습니다. 내외국인 비교는 데이터랩 데이터가 있는 분만 추가로 해 봅니다.
traps_check.md의 10줄이 모두 해당없음/확인함/걸림으로 채워졌는지 봅니다. "걸림" 항목 중 하나를 골라 원본 데이터나 출처 설명을 직접 열어 맞는지 확인하고, 위 "실제로 걸리는 함정" 표와 겹치는 게 있는지도 봅니다.
빨리 끝났다면 (선택 과제)
① 상권 추정매출에서도 시간대별 매출 비중을 그려, 생활인구가 많은 시간대와 매출이 나는 시간대가 같은지 비교합니다(Colab 노트북 7번 칸). ② 내 구의 이상치 날짜를 구별로 3개씩 뽑아 봅니다. 4개 구를 섞어 정렬하면 인구가 가장 적은 구만 나오니 daily.sort_values("일평균_생활인구").groupby("자치구").head(3)처럼 구별로 봅니다.