데이터 결합하고 인사이트 찾기
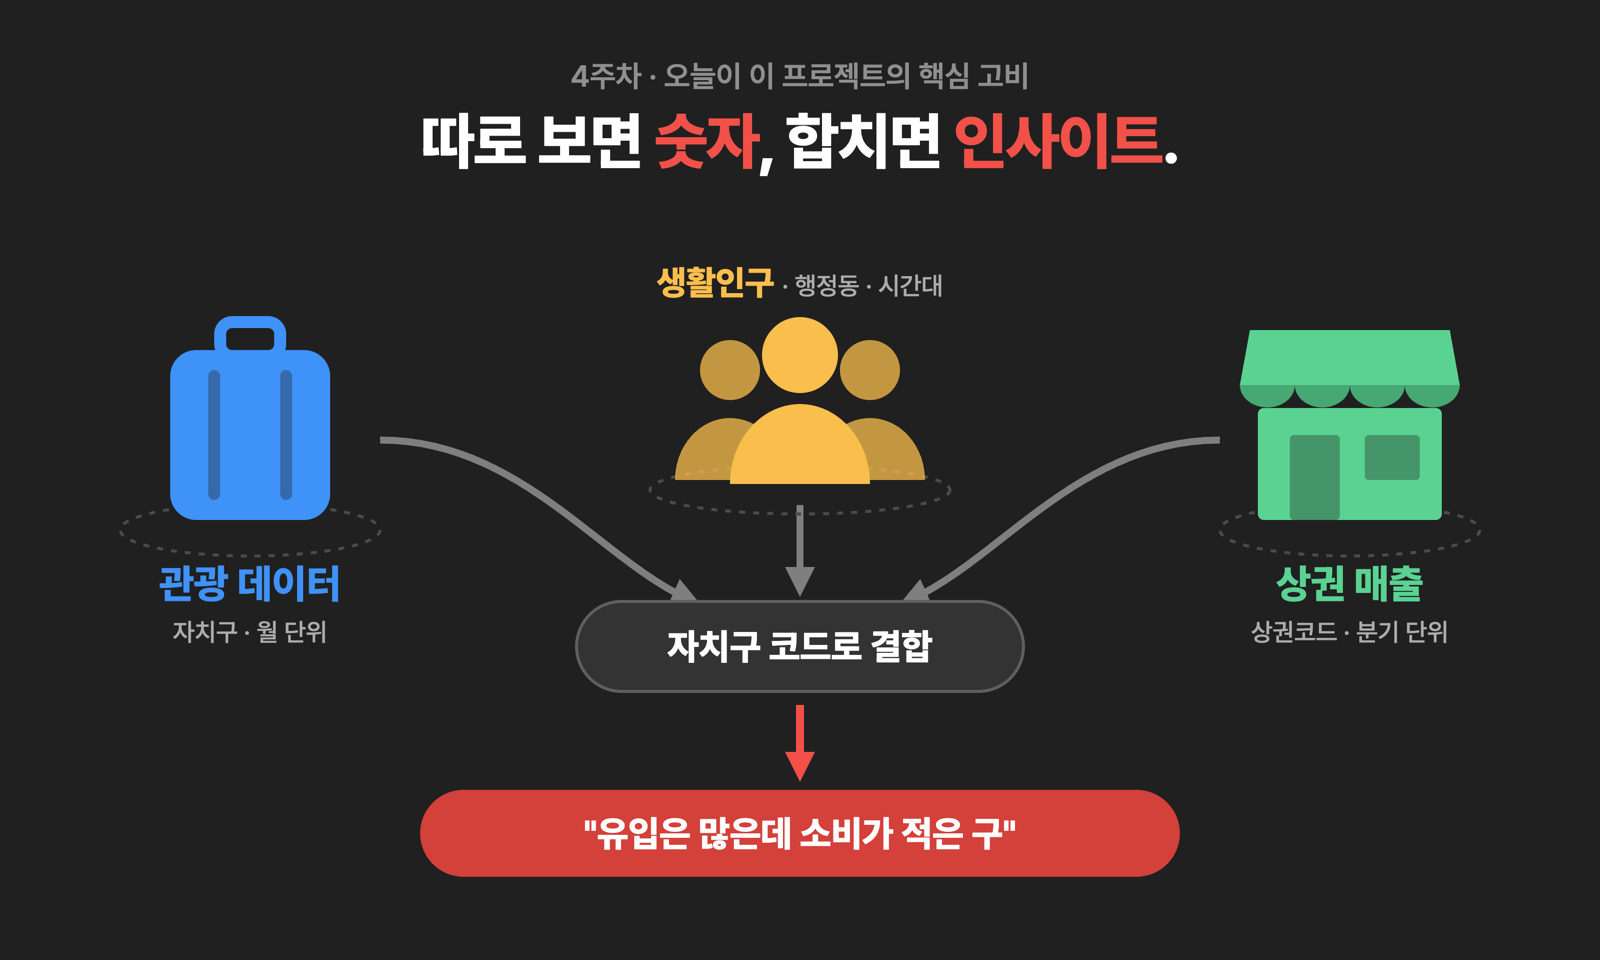
따로 보면 각각의 숫자일 뿐인 관광 데이터와 상권 데이터를 하나로 합쳐야 "유입은 많은데 소비로 안 이어지는 지역"이 보입니다. 오늘이 이 프로젝트의 핵심 고비입니다.
 폴백용 Colab 노트북(설치가 막힌 경우)
분석 단위는 자치구로 고정합니다
지역 코드 3종
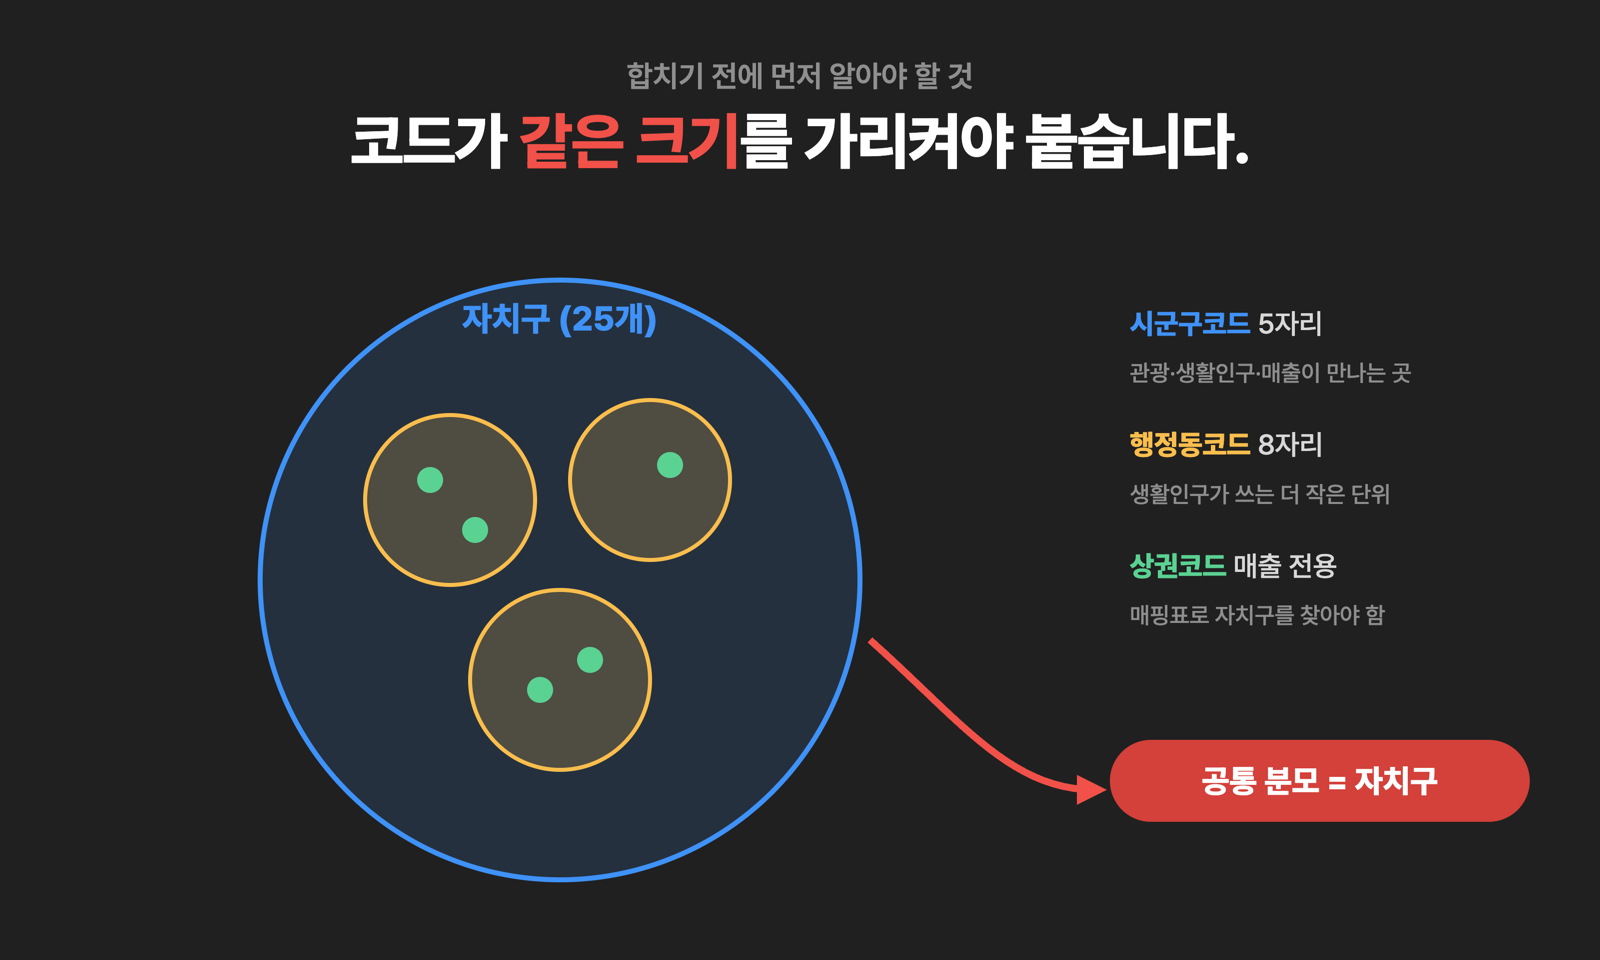
5자리. 자치구 단위. 관광 데이터·집계된 생활인구·상권 데이터가 여기서 만납니다.
8자리. 생활인구·상권분석서비스 내부에서 쓰는 더 세밀한 단위.
상권분석서비스 전용. "영역-상권" 매핑표로 행정동코드로 바꿀 수 있습니다.
오늘의 결합 순서
세 단계로 자치구 단위 표 하나를 만듭니다.
행정동 단위 데이터를 자치구로 묶기
- 생활인구를 자치구 코드로
groupby - 상권매출을 "영역-상권" 매핑표로 자치구 코드를 붙인 뒤
groupby
자치구 기준으로 하나의 표로 합치기
- 관광 데이터(자치구 단위)와
merge - "방문자수 대비 매출" 같은 비율 지표 계산
💡 팁: 상권매출 CSV 자체에는 행정동·자치구 컬럼이 없습니다. 반드시 "영역-상권" 매핑표와 상권코드로 먼저 조인해야 자치구를 알 수 있습니다.
잠깐, 스킬이 정확히 뭔가요?
스킬은 SKILL.md라는 텍스트 파일 하나입니다. 맨 위 description에는 "언제 쓰는지"가, 본문에는 "어떤 순서로, 무엇은 하면 안 되는지, 결과를 어떤 파일 이름으로 남기는지"가 적혀 있습니다. Claude Code·Codex는 평소엔 description만 보고 있다가, 요청이 맞으면 본문을 펴서 그대로 따릅니다.
그래서 같은 "정리해줘"라도 결과가 달라집니다. 스킬 없이 시키면 AI가 이상치를 조용히 지우거나 원본을 덮어쓸 수 있지만, 2-collect 본문에는 "이상치는 지우지 않고 표시만", "원본 덮어쓰기 금지", "행을 지우면 사유와 건수 기록"이 박혀 있습니다. 결과도 매번 같은 폴더·파일 이름으로 나오니 다음 스킬이 그대로 이어받습니다.
| 스킬 | 하는 일 | 남기는 파일 |
|---|---|---|
| 1-hypothesis | 목표·가설·판정 기준 | hypothesis.md |
| 2-collect | 확보와 정리 (오늘: 결합) | data/clean/, collection_report.md |
| 3-suspect | EDA와 함정 10개 판정 (오늘) | eda_report.html, traps_check.md |
| 4-report | 한 장 리포트 (5주차) | report_YYYYMMDD.html |
| data-shorts-skill | 1분 영상 (5주차) | out/video.mp4 |
💡 오늘 두 가지만 주의하세요. ① 2-collect에는 "데이터를 어떻게 합치는지" 절차가 따로 없습니다. 무엇과 무엇을 어떤 코드로 붙일지(상권_코드 → 매핑표 → 시군구코드)를 프롬프트에 직접 적어야 합니다. ② 2-collect는
hypothesis.md가 없으면 1-hypothesis로 먼저 돌려보냅니다. 1주차 가설을 손으로만 적었다면 "1주차 질문·가설로 hypothesis.md부터 만들어줘"를 앞에 붙이세요.
2-collect로 결합, 3-suspect로 한 번 더 확인
결합 자체는 2-collect 스킬에게 맡기고, 합친 결과가 말이 되는지는 3-suspect로 한 번 더 확인합니다. 결합한 뒤에는 특히 두 함정을 봅니다. 4번 평균의 함정: 자치구 평균 하나에 특정 상권·업종의 효과가 묻히거나 끌려갑니다(3주차 종로구 예시에서 시계·귀금속이 실제로 그랬습니다). 10번 구조 보정: 매출이 큰 구는 원래 상권이 커서일 수 있으니 "방문자수 대비 매출"처럼 나눠서 비교합니다.
"생활인구 데이터(컬럼: 행정동코드, 총생활인구수 등)와 상권매출 데이터(컬럼: 상권_코드, 당월_매출_금액 등), 상권코드-행정동코드-시군구코드 매핑표가 있어. 2-collect 스킬로 (자치구명)의 자치구 단위 생활인구 합계와 상권매출 합계를 구해 하나의 표로 합쳐줘. 그다음 3-suspect로 평균의 함정(특정 상권·업종 하나가 평균을 왜곡하는지)과 구조 보정(규모 차이를 비율로 나눠 봤는지)을 확인해줘."
기간도 먼저 맞춥니다
지역 단위만 맞추면 끝이 아닙니다. 세 데이터는 시간 단위도 다릅니다. 합치기 전에 기준 기간을 하나로 정하고(이 과정은 2025년 1년치를 권장), 각 데이터를 그 기간 안에서 같은 단위로 먼저 집계합니다.
분기. 기준_년분기_코드가 20251~20254처럼 분기 단위. 그대로 쓰거나 1년 합계로.
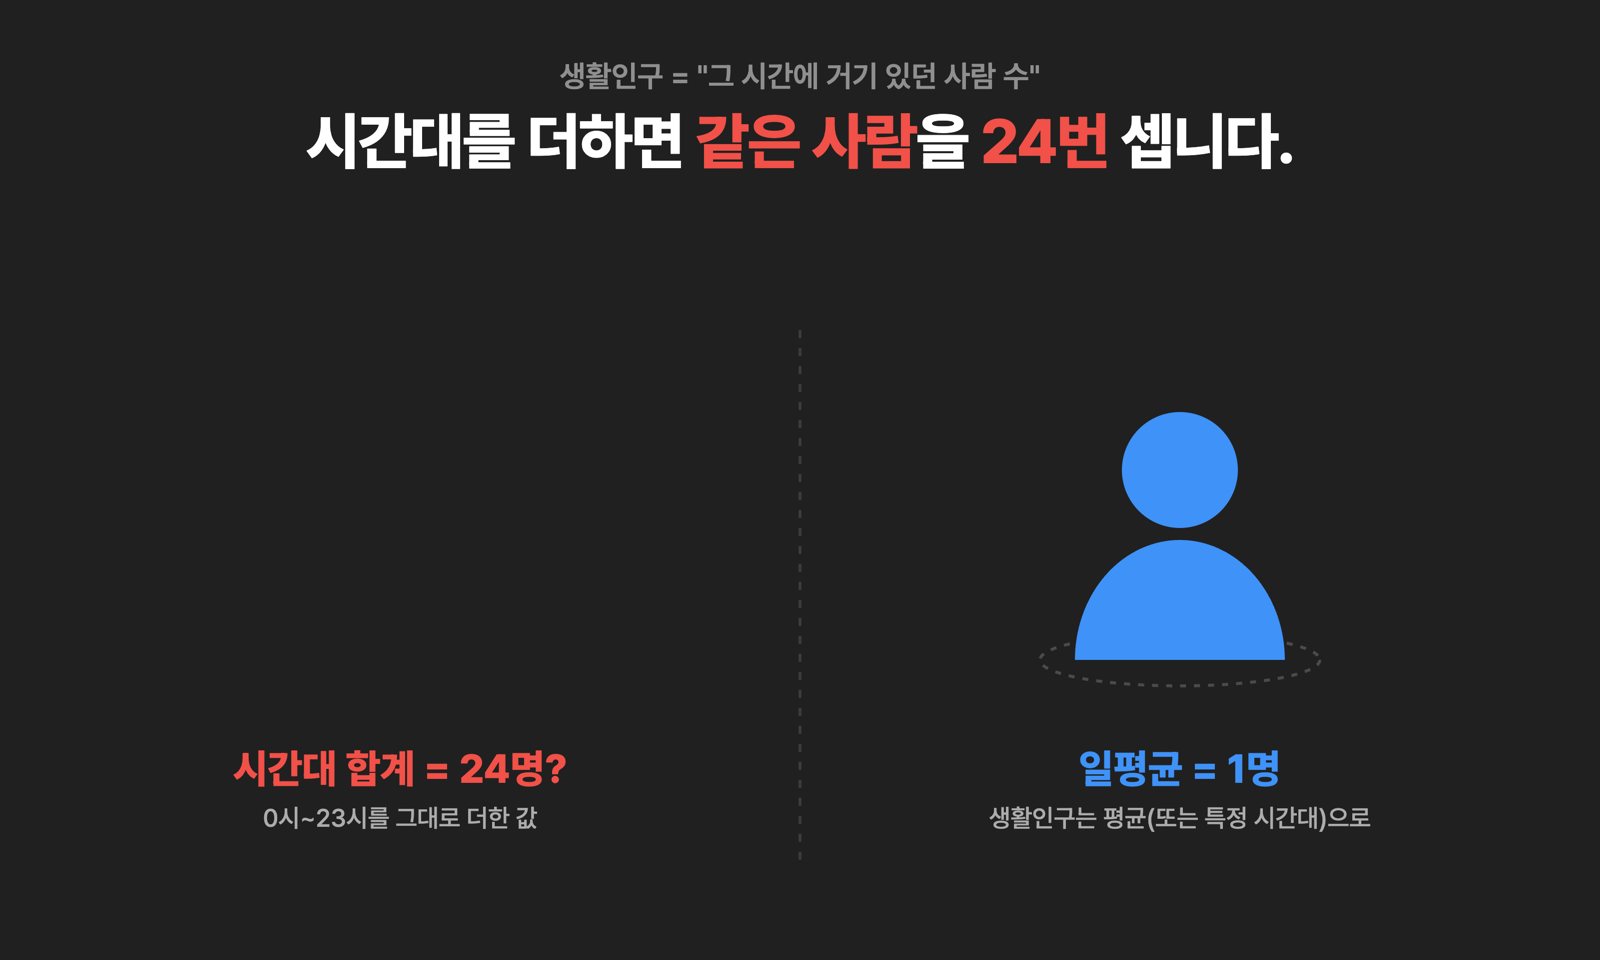
일·시간대. 하루 24행이라 그대로 더하면 안 됩니다. "하루 평균 생활인구"로 집계.
월. 월별 방문자수를 분기 또는 1년 합계로 묶습니다.
💡 합계와 평균을 구분합니다. 매출·방문자수는 기간 합계가 자연스럽지만, 생활인구는 "그 시간에 그 지역에 있던 사람 수"라 시간대를 더하면 같은 사람을 24번 세는 셈입니다. 생활인구는 일평균(또는 특정 시간대)으로 씁니다.
대시보드를 파일로 저장하고 공유하기
plotly 차트는 fig.write_html("dashboard.html")로 저장하면 브라우저에서 열리는 인터랙티브 파일이 됩니다. 로컬 폴더에 그대로 생기니 Drive나 메일로 보내면, 받는 사람도 필터와 호버가 되는 그대로 봅니다(Colab 폴백 경로면 왼쪽 파일 탭에서 내려받습니다). 포트폴리오에는 ① dashboard.html 파일 ② 스크린샷 1장을 함께 둡니다.
"자치구 단위로 결합한 이 표로 plotly 대시보드를 만들어줘. 드롭다운으로 자치구를 고르면 월별 방문자수와 매출이 같이 보이는 차트 1개, 그리고 '유입 대비 소비' 비율이 낮은 순으로 자치구를 나열한 막대 차트 1개. 마지막에 fig.write_html('dashboard.html')로 저장하는 코드까지 넣어줘."
💡 링크 하나로 열리는 웹앱(Streamlit 등)은 GitHub 계정과 배포 절차가 더 필요해 이 과정에서는 다루지 않습니다. 파일과 Colab 링크로 충분히 포트폴리오가 됩니다.
세 가지 코드(시군구·행정동·상권)가 어느 수준을 가리키는지 알아야 결합이 됩니다. 관광 데이터의 한계(자치구까지만) 때문에 오늘의 분석 단위는 자치구이고, 기간은 2025년으로 맞춥니다.
🧪 4주차 실습 · 단계별 미션
시나리오 — 3주차에 정리한 내 데이터를 자치구 단위로 합쳐 첫 인사이트를 뽑고, 대시보드 초안을 만듭니다.
생활인구·상권매출을 자치구 단위로 집계하고, 관광 데이터와 합칩니다.
"유입 대비 소비" 같은 비율 지표를 만들어, 눈에 띄는 자치구 1~2곳을 찾습니다.
plotly로 인터랙티브 차트 최소 1개를 만듭니다.